Des moddeurs lèvent une limitation des Tensor Cores sur les GeForce RTX 20, 30 et 40 |
————— 26 Octobre 2026 à 11h13 —— 439 vues



Des moddeurs lèvent une limitation des Tensor Cores sur les GeForce RTX 20, 30 et 40 |
————— 26 Octobre 2026 à 11h13 —— 439 vues
Depuis l’arrivée des GeForce RTX en 2018 et l’introduction des Tensor Cores avec l’architecture Turing, NVIDIA n’a cessé de booster les capacités de calcul IA de ses cartes graphiques au fil des générations. Ces unités spécialisées dans les opérations matricielles servent aussi bien à certaines fonctions de rendu, comme le DLSS, qu’à l’exécution de modèles d’IA en local. Or, ces GeForce RTX n’exploitent pas pleinement leur potentiel dans certains modes de calcul. Des moddeurs ont découvert un moyen de lever ces limitations. Ils ont obtenu des gains théoriques de parfois 100 %. En pratique, les applications d’intelligence artificielle n’en profitent néanmoins pas dans les mêmes proportions.
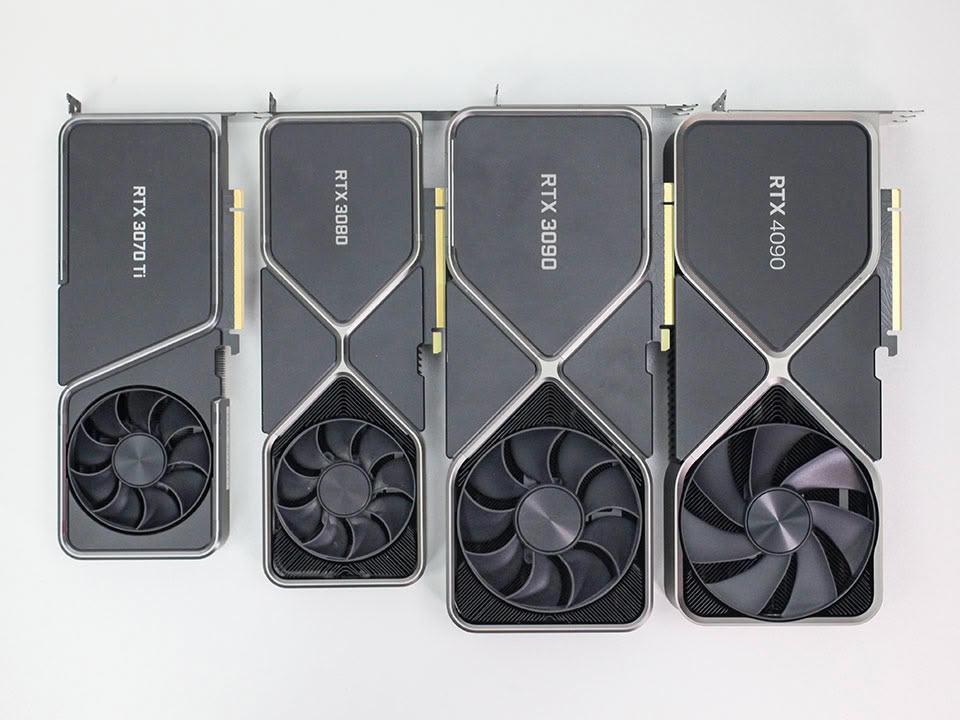
© TPU
Ces travaux reposent sur la modification de registres de configuration du GPU afin de rétablir le débit maximal de certaines instructions de calcul. Selon le projet, l’opération intervient au démarrage de la machine ou via un module chargé avant le pilote NVIDIA. Elle ne nécessite pas de modifier le VBIOS. Les changements restent temporaires mais ils peuvent être réappliqués automatiquement.
Il y a autant de projets que de générations. GPU-Unlock-Ada concerne les RTX 40, quand GPU-Unlock cible les GeForce RTX 30. Quant aux RTX 20, basées sur l’architecture Turing, elles bénéficient d’une solution appelée, préparez-vous, Turing-Unlock. Toutes visent principalement Linux, même si quelques implémentations expérimentales existent déjà sous Windows.
Les publications font état d'un débit presque doublé sur les opérations Tensor FP16 et BF16 avec accumulation FP32. Sur une GeForce RTX 4090, il passe ainsi d'environ 166 à 332 TFLOPS dans ces deux modes de calcul. Avec une RTX 3090 Ti, les performances en multiplication de matrices BF16 progressent de 87,5 à 157,4 TFLOPS, soit un gain d’environ 80 %. Enfin, une RTX 2080 Ti atteint 111 TFLOPS contre 59,9 TFLOPS avant modification dans un test FP16 avec accumulation FP32.
GeForce RTX 4090 :
| Mode | Avant | Après |
|---|---|---|
| FP16 → FP32 accumulate | 165,6 TF/s | 331,6 TF/s |
| BF16 → FP32 accumulate | 165,5 TF/s | 330,6 TF/s |
RTX 3090 Ti :
| Input | Avant | Après |
|---|---|---|
| FP16 | 87,46 TFLOPS | 118,39 TFLOPS |
| BF16 | 87,50 TFLOPS | 157,41 TFLOPS |
| TF32 | 42,58 TFLOPS | 82,61 TFLOPS |
RTX 2080 Ti :
| Workload | Locked | Unlocked | Changement |
|---|---|---|---|
| FP16-input / FP32-accumulation MMA, FLOP/SM/clock | 511,6652 | 1022,438 | 1,9983× |
| Same MMA, TFLOPS | 46,9361 | 93,6649 | 1,9956× |
| cuBLAS 8192 GEMM, TFLOPS | 48,1488 | 85,1705 | 1,7689× |
| FP16-input / FP16-accumulation MMA, FLOP/SM/clock | 1022,1337 | 1022,1171 | Inchangé |
Cela dit, doubler le débit d’une opération ne signifie pas diviser par deux le temps nécessaire à une tâche d’IA. D’autres limites matérielles et facteurs logiciels entrent en jeu. Les premiers essais sur des modèles de langage exécutés localement l’illustrent. Avec une RTX 3090, le traitement d’un prompt progresse d’environ 14 à 36 % selon les configurations rapportées. En revanche, la génération des tokens suivants évolue peu. Probablement parce que cette étape dépend davantage de la bande passante mémoire que du débit des Tensor Cores.
Bien sûr, ces débridages ne transforment pas subitement une RTX 20 en RTX 50. Néanmoins, ce sont autant d’outils pour les propriétaires d’anciennes GeForce qui souhaiteraient mieux exploiter leur carte pour l’IA locale. Certains demandent d’ailleurs à NVIDIA de lever officiellement ces restrictions. D’autres redoutent que tout ceci renforce l’attrait des anciennes GeForce auprès des utilisateurs d’IA, au détriment des joueurs, sur un marché déjà sous forte tension. De fait ces modifications n’ont pas vocation à améliorer les performances dans les jeux.
Enfin, NVIDIA n’a pas officiellement détaillé les raisons de cette limitation. La segmentation entre GeForce et cartes professionnelles constitue l'explication. Sur certaines générations, les cartes professionnelles affichent un débit supérieur à celui des GeForce pour les opérations FP16 et BF16 avec accumulation FP32, ces dernières étant limitées à la moitié de leur cadence maximale dans ces modes. Ces modifications visent ainsi à rétablir, sur les cartes grand public compatibles, un débit de calcul comparable à celui fourni par les RTX Pro.


